Llama 2 vs ChatGPT

이 내용은 ‘Llama 2’와 ‘ChatGPT’ 간의 비교를 다룬 내용으로, ‘Llama 2’가 ‘ChatGPT’보다 우수하다는 주장과 함께 두 모델 간의 차이와 각각의 장점을 설명하고 있습니다.

**Llama 2 vs ChatGPT 어떤 것이 더 좋은 AI 모델인가?**
‘ChatGPT’의 대안으로 강력한 존재로 등장한 ‘Llama 2’는 Meta(이전의 Facebook)에 의해 개발되었습니다. ‘Llama 2’는 ‘ChatGPT’에 비해 몇 가지 장점을 제공합니다.

**모델 비교:**
– ‘Llama 2’와 ‘ChatGPT’는 모두 인간과 유사한 텍스트를 생성하는 대형 언어 모델입니다. 그러나 ‘Llama 2’는 연구 및 상업 목적으로 자유롭게 다운로드하고 사용할 수 있는 오픈 소스 모델입니다. 반면에 ‘ChatGPT’는 OpenAI에서 제공하는 API를 통해서만 액세스할 수 있는 닫힌 제품이며, 사용에 비용이 발생할 수 있습니다.

**모델 성능:**
– ‘Llama 2’는 벤치마크 테스트에서 일정 부분의 우수한 성과를 보여주었습니다. 이러한 결과는 ‘Llama 2’가 ‘ChatGPT’를 능가하고 더 정확하고 유익한 응답을 제공할 수 있음을 보여줍니다. 특히 ‘Llama 2’는 안전성에 중점을 두고, 인간의 선호도에 맞게 응답하고 개인 정보를 노출하지 않도록 세밀하게 조정되었습니다. ‘Llama 2’는 ‘ChatGPT’와 비교하여 더 안전하다고 평가되었습니다.

**데이터 업데이트 및 이용:**
– ‘Llama 2’는 ‘ChatGPT’보다 최근 데이터를 사용하며, 2022년 9월까지의 정보를 갖고 있습니다. 이는 ‘ChatGPT’에 비해 더 최신 정보를 반영할 수 있다는 것을 의미합니다.

**접근성:**
– ‘Llama 2’는 오픈 소스 모델로, 사용자가 모델을 무료로 다운로드하고 수정하여 개발자 및 연구자가 특정 목적에 맞게 사용할 수 있습니다. 이 자유롭고 유연한 특성은 자체 챗봇 또는 언어 모델을 만들고자 하는 사람들에게 유용합니다.

**라이센싱 계약:**
– ‘Llama 2’의 라이센싱 계약은 연구 및 상업적 사용에 무료로 이용 가능하다는 큰 장점을 제공합니다. 이전 모델과 비교했을 때, 이러한 계약은 더 많은 미세 조정이 필요하지 않고, 성능과 사용성을 향상시킬 수 있습니다.

**안전 기능:**
– ‘Llama 2’는 개선된 안전 기능을 제공하며 사용자의 개인 정보를 안전하게 보호합니다.

**성능 비교:**
– ‘Llama 2’는 4,000개의 프롬프트를 사용한 벤치마크 테스트에서 ‘ChatGPT’보다 더 좋은 성능을 보였습니다.

**미래 개발:**
– ‘Llama 2’는 미래에 대한 기대감을 높이며, 지속적인 업데이트로 더 나은 성능과 능력을 기대할 수 있습니다.

**현재 이용 방법(2023년 11월)**

쿼안타이즈 된( 모델 경량화)된 것이 허깅페이스에 있습니다.
https://huggingface.co/TheBloke

이 내용은 ‘Llama 2’의 장점과 ‘ChatGPT’와의 비교에 대한 자세한 내용을 다루고 있으며, ‘Llama 2’가 다양한 산업 분야에서 적용 가능성을 제공하는 점에 초점을 맞추고 있습니다. ‘Llama 2’는 ‘ChatGPT’보다 더 많은 오픈 소스 옵션과 성능 향상 기대가 있는 모델로 소개되었습니다.
AI 용어 – 최소한의 파라미터로 사전 훈련된 모델 – LoRA(저랭크 적응, Low-Rank Adaptation)

LoRA(저랭크 적응, Low-Rank Adaptation)는 대규모 언어 모델의 파라미터 수를 크게 줄이면서도 모델의 성능을 유지하는 방법입니다. 일반적으로 대규모 모델을 훈련시킬 때, 전체 모델을 다시 훈련시키는데는 막대한 비용과 시간이 소요됩니다. LoRA는 이러한 문제를 해결하기 위한 방법으로 개발되었습니다.

일반적으로, 예를 들어 GPT-3 175B와 같이 거대한 언어 모델을 사용할 때, 모델을 특정 작업이나 도메인에 맞게 재조정하려면 독립된 모델을 새로 훈련해야 합니다. LoRA는 이런 부담을 줄이기 위해 개발되었습니다.

LoRA의 아이디어는 기존의 사전 훈련된 모델 가중치를 동결하고, 각 레이어의 파라미터 수를 크게 줄이면서도 모델의 유용성을 유지하는 것입니다. 이를 위해 각 레이어에 훈련 가능한 랭크 분해 행렬을 주입합니다. 이 방식은 모델의 훈련 가능한 파라미터 수를 크게 줄여주는 동시에 메모리 요구량을 줄여줍니다.

결과적으로 LoRA를 적용하면, 파라미터 수를 크게 줄일 수 있으면서도 모델의 품질이 크게 하락하지 않는다는 것입니다. 이는 효율적으로 훈련 가능한 파라미터 수를 줄여 비용을 절감하면서도 모델의 성능을 유지할 수 있는 방법을 제시합니다.

논문.

“Low-Rank Adaptation of Large Language Models” (LoRA)에 대한 논문 요약입니다. 이 논문은 자연어 처리의 중요한 패러다임 중 하나인 일반 도메인 데이터의 대규모 사전 훈련과 특정 작업 또는 도메인에 대한 적응을 다룹니다.

논문에서는 대규모 모델을 사전 훈련할수록 모든 모델 파라미터를 다시 훈련하는 “full fine-tuning”이 점차 더 어려워진다는 문제점을 지적합니다. 예를 들어 GPT-3 175B를 사용한다면, 각각이 175B의 파라미터를 가진 독립적인 fine-tuned 모델을 배포하는 것이 매우 비용이 많이 든다고 합니다.

LoRA는 이러한 문제를 해결하기 위해 제안되었는데, 사전 훈련된 모델 가중치를 유지하고 Transformer 아키텍처의 각 레이어에 학습 가능한 랭크 분해 행렬을 삽입하여 하위 작업의 학습 가능한 파라미터 수를 크게 줄입니다. LoRA는 Adam으로 fine-tuning 된 GPT-3 175B와 비교하여 학습 가능한 파라미터 수를 10,000배 줄이고 GPU 메모리 요구량을 3배로 줄일 수 있다고 합니다.

LoRA는 RoBERTa, DeBERTa, GPT-2 및 GPT-3의 모델 품질에서 fine-tuning과 유사하거나 더 우수한 성능을 보이며, 학습량이 더 높고 어댑터와 달리 추가적인 추론 지연이 없습니다. 이를 통해 언어 모델 적응에서 랭크 결핍에 대한 실험 결과를 제공하여 LoRA의 효과를 밝히고 있습니다.

이 논문은 PyTorch 모델과 LoRA를 통합하는 데 도움을 주는 패키지를 제공하고 있으며, RoBERTa, DeBERTa 및 GPT-2의 구현과 모델 체크포인트를 이용할 수 있도록 URL을 제공합니다. 이 논문은 Computation and Language (cs.CL); Artificial Intelligence (cs.AI); Machine Learning (cs.LG) 분야의 arXiv:2106.09685에 출판되었습니다.

더 많은 정보를 원한다면, 해당 링크인 https://doi.org/10.48550/arXiv.2106.09685를 참조할 수 있습니다.


활성화 함수(Activation Function)

활성화 함수(Activation Function)는 인공 신경망의 각 뉴런에서 입력 신호의 가중합을 출력값으로 변환하는 함수를 말합니다. 이 함수는 인공 신경망의 비선형성을 추가하고, 신경망이 복잡한 함수를 근사하고 다양한 패턴을 학습할 수 있도록 합니다.

활성화 함수는 다음과 같은 역할을 합니다:

1. 비선형성 추가: 활성화 함수는 입력과 가중치의 선형 결합을 비선형 함수로 변환합니다. 이것은 신경망이 복잡한 함수를 모델링하고 다양한 종류의 데이터 패턴을 파악할 수 있게 합니다. 선형 함수만으로는 다층 신경망이 복잡한 문제를 풀 수 없습니다.

2. 신경망의 출력 생성: 활성화 함수는 출력층의 뉴런에서 최종 예측 값을 생성합니다. 예를 들어, 분류 문제의 경우 확률값을 출력하기 위해 시그모이드 활성화 함수가 사용될 수 있고, 회귀 문제의 경우 선형 활성화 함수가 사용될 수 있습니다.

일반적으로 사용되는 활성화 함수에는 다음과 같은 것들이 있습니다:

– 시그모이드(Sigmoid) 함수: 주로 이진 분류 문제의 출력층에 사용됩니다.
– 하이퍼볼릭 탄젠트(Tanh) 함수: 신경망의 은닉층에서 사용되며, 입력값을 -1과 1 사이로 압축합니다.
– 렐루(ReLU, Rectified Linear Unit) 함수: 은닉층에서 많이 사용되며, 입력이 양수일 때 선형적인 활성화를 수행하고 음수일 때 0으로 변환합니다.
– 리키 렐루(Leaky ReLU) 함수: ReLU의 변형으로, 음수 값에 작은 기울기를 부여하여 “죽은 뉴런” 문제를 완화시킵니다.
– GELU(Gaussian Error Linear Unit) 함수: 뉴런의 출력을 훈련하는 데 더 용이하게 만드는 새로운 활성화 함수입니다.

각 활성화 함수는 특정 문제나 아키텍처에 따라 적합한 역할을 수행합니다.

10 위치 인코딩(임베딩)을 언어 모델(LanguageModel)에 통합 – 납치를 해서라도 구할 고급 AI 개발자 양성 과정 – 밑바닥 부터 시작하는 GPT

class PositionalEmbedding(nn.Module):
    def __init__(self, n_embd, max_len=512):
        super().__init__()
        position = torch.arange(0, max_len).unsqueeze(1).float()
        div_term = torch.exp(torch.arange(0, n_embd, 2).float() * -(math.log(10000.0) / n_embd))
        pe = torch.zeros(max_len, n_embd)
        pe[:, 0::2] = torch.sin(position * div_term)
        pe[:, 1::2] = torch.cos(position * div_term)
        self.pe = pe.unsqueeze(0)
        self.register_buffer('pe', pe)

    def forward(self, x):
        return x + self.pe[:, :x.size(1)].detach()

# 언어 모델을 정의하는 함수
class LanguageModel(nn.Module):
    def __init__(self, vocab_size):
        super().__init__()
        self.token_embedding_table = nn.Embedding(vocab_size, n_embd)
        self.position_embedding = PositionalEmbedding(n_embd)
        self.ln_f = nn.LayerNorm(n_embd)
        self.head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        tok_emb = self.token_embedding_table(idx)
        pos_emb = self.position_embedding(torch.arange(idx.size(1), device=device))
        x = tok_emb + pos_emb
        logits = self.head(self.ln_f(x))

주어진 코드는 Transformer 기반의 언어 모델을 구현하는 파이썬 클래스 `PositionalEmbedding`과 `LanguageModel`을 포함하고 있습니다. 이 모델은 토큰 임베딩과 위치 임베딩을 조합하여 문장의 토큰들을 처리하고, 최종 출력(logits)을 생성하는 역할을 합니다.

#### `PositionalEmbedding` 클래스:
이 클래스는 위치 임베딩(Positional Embedding)을 생성하고 관리하는 역할을 합니다.

– `__init__(self, n_embd, max_len=512)`: 초기화 메서드에서는 위치 임베딩을 생성하는데 필요한 파라미터들을 받습니다. `n_embd`는 임베딩 벡터의 차원을 나타내며, `max_len`은 시퀀스의 최대 길이를 나타냅니다.

– 위치 임베딩은 사인(Sine)과 코사인(Cosine) 함수를 사용하여 생성됩니다. `position` 변수는 0부터 `max_len-1`까지의 숫자를 포함하는 벡터를 생성합니다.

– `div_term` 변수는 위치 임베딩에서 사용되는 분모 항(divisor term)으로, 특정 패턴을 생성하기 위해 계산됩니다.

– `pe` 변수는 위치 임베딩 행렬을 초기화합니다. 이 행렬의 크기는 `(max_len, n_embd)`이며, 모든 값은 초기에 0으로 설정됩니다. 그런 다음, 홀수 열(`[:, 1::2]`)에는 코사인 함수 값을 할당하고, 짝수 열(`[:, 0::2]`)에는 사인 함수 값을 할당하여 위치 임베딩을 생성합니다.

– `self.pe` 변수는 위치 임베딩을 담고 있는 텐서를 가리킵니다. 이 텐서는 모델 학습 중에 업데이트되지 않습니다.

– `forward(self, x)`: 이 메서드는 입력으로 받은 `x`에 위치 임베딩을 더한 결과를 반환합니다. 위치 임베딩을 더할 때 `.detach()`를 사용하여 위치 임베딩이 모델의 역전파(backpropagation)에 의해 업데이트되지 않도록 합니다. 따라서 위치 임베딩은 고정된 패턴을 나타냅니다.

#### `LanguageModel` 클래스:
이 클래스는 언어 모델을 나타내며, 토큰 임베딩과 위치 임베딩을 조합하여 최종 입력을 생성하고 출력(`logits`)을 반환합니다.

– `__init__(self, vocab_size)`: 초기화 메서드에서는 언어 모델을 초기화합니다. `vocab_size`는 어휘 사전의 크기를 나타냅니다.

– `self.token_embedding_table`은 토큰 임베딩 테이블로, 단어 인덱스를 임베딩 벡터로 매핑하는 역할을 합니다.

– `self.position_embedding`은 앞서 정의한 `PositionalEmbedding` 클래스의 인스턴스로, 위치 임베딩을 생성합니다.

– `self.ln_f`는 Layer Normalization을 수행하는 레이어를 초기화합니다. 이는 모델의 안정성과 학습 성능을 향상시키는데 사용됩니다.

– `self.head`는 선형 레이어(Linear Layer)로, 최종 출력을 생성하는 역할을 합니다. 입력으로부터 예측 값을 만들어냅니다.

– `forward(self, idx, targets=None)`: 이 메서드는 주어진 토큰 인덱스(`idx`)를 입력으로 받아, 토큰 임베딩과 위치 임베딩을 더하여 최종 입력(`x`)을 생성합니다. 그 후, `self.head`를 사용하여 최종 출력(logits)을 생성합니다. 최종 출력은 모델의 예측 값입니다.

코드에서 `PositionalEmbedding` 클래스는 Transformer 모델에서 위치 정보를 주입하기 위한 중요한 부분이며, `LanguageModel` 클래스는 토큰과 위치 임베딩을 결합하여 모델의 입력을 생성하고, Layer Normalization과 선형 레이어를 사용하여 모델의 출력을 생성하는 역할을 합니다.

어텐션 모델의 위치 임베딩(Positional Embedding)

어텐션 모델의 위치 임베딩(Positional Embedding)은 문장이나 시퀀스 내에서 단어의 위치 정보를 벡터로 표현하는 기법입니다. 어텐션 메커니즘은 주로 단어 간의 상대적인 위치 정보를 활용하여 중요한 단어에 집중하고 관련 정보를 파악하는 데 사용됩니다. 하지만 어텐션 모델은 단어들을 순서대로 처리하며 위치 정보를 명시적으로 제공하지 않기 때문에 위치 임베딩을 따로 사용하여 이를 보완합니다.

일반적으로 위치 임베딩은 삼각 함수(주로 사인과 코사인 함수)를 활용하여 단어의 위치를 벡터로 인코딩합니다. 이 함수들은 서로 다른 파장과 주기를 가지며, 각 위치에 대한 고유한 패턴을 생성합니다. 이렇게 생성된 위치 임베딩을 단어의 임베딩과 더하여 최종 입력으로 활용합니다. 위치 임베딩은 어텐션 메커니즘이 단어의 상대적 위치를 이해하고 문맥을 파악하는 데 도움을 줄 수 있습니다.

유사도 내적 계산

유사도 내적 계산은 벡터 간의 유사도를 측정하는 한 가지 방법입니다. 벡터는 숫자들의 배열로 이루어진 개념으로, 예를 들면 [1, 2, 3]과 같이 나타낼 수 있습니다. 벡터 간의 유사도는 두 벡터가 얼마나 비슷한지를 나타내는 척도로 사용됩니다.

유사도 내적 계산은 두 벡터의 대응하는 요소들을 각각 곱한 뒤 그 결과들을 모두 더하여 유사도 값을 구합니다. 이러한 연산을 요소별 곱(또는 Hadamard 곱)과 합으로 표현할 수 있습니다.

두 벡터 A와 B의 유사도 내적 계산은 다음과 같습니다:

유사도 내적 값 = Σ(A[i] * B[i]) for i = 0 to N-1

여기서 N은 벡터의 차원을 의미하며, A[i]와 B[i]는 각 벡터의 i번째 요소를 나타냅니다.

유사도 내적 계산은 머신러닝, 자연어 처리 등 다양한 분야에서 중요한 개념으로 활용됩니다. 예를 들어, 어텐션 메커니즘에서는 쿼리와 키 간의 유사도 내적을 사용하여 중요한 정보를 찾고, 벡터 간의 유사도 내적 값을 비교하여 유사성을 평가하는데 활용됩니다.

Self-attention의 개념과 핵심 개념 1 – “Query, Key, Value” 메커니즘

Self-attention은 자연어 처리와 기계 번역 등 다양한 딥 러닝 기반의 모델에서 중요한 개념 중 하나입니다. Self-attention은 입력 시퀀스 내의 단어들 간의 관련성을 파악하고, 각 단어의 중요도를 계산하여 새로운 표현을 생성하는 메커니즘입니다. 이를 통해 모델은 입력 시퀀스 내에서 중요한 정보를 효과적으로 파악하고, 문장의 의미를 이해하는 데 도움을 줍니다.

Self-attention의 핵심 개념은 “Query, Key, Value” 메커니즘으로 설명됩니다. 간단히 말하면, 입력 시퀀스 내의 각 요소(예: 단어)에 대해 세 가지 벡터를 생성하는 것입니다.

1. Query(Q): Query 벡터는 해당 요소(단어)가 다른 요소들과 어떤 관련성을 가지는지를 파악하는 역할을 합니다. 즉, 자기 자신에게 질문을 던지는 벡터로 볼 수 있습니다. 이렇게 생성된 Query 벡터는 입력 시퀀스 내의 다른 모든 요소들과의 유사도를 계산하는 데 사용됩니다.

2. Key(K): Key 벡터는 Query와 유사도를 계산하는 데 사용되는 벡터로서, 해당 요소와 다른 요소들과의 유사도를 측정합니다. Key 벡터는 입력 시퀀스 내의 모든 요소들에 대해 생성됩니다.

3. Value(V): Value 벡터는 해당 요소의 중요도를 나타내는 벡터입니다. 이 벡터는 가중치를 부여하는 데 사용되며, 입력 시퀀스 내의 각 요소들에 대해 생성됩니다.

이렇게 생성된 Query, Key, Value 벡터를 사용하여 입력 시퀀스 내의 각 요소와 다른 모든 요소들 간의 유사도를 계산하고, 이를 기반으로 각 요소에 대한 다른 가중치를 부여합니다. 이를 통해 모델은 자기 자신에게 질문을 던지는 것처럼 입력 시퀀스 내의 중요한 정보와 관련성을 파악하고, 새로운 표현을 생성합니다. 이러한 과정을 통해 Self-attention은 입력 시퀀스 내의 단어들 간의 상호작용을 강화하고, 다양한 자연어 처리 작업에 유용하게 활용됩니다.

구글 바드(BARD)와 ChatGPT의 근본적인 차이점 – 구글 바드는 도구를 활용한다.

구글 BARD와 ChatGPT의 근본적인 차이점은 다음과 같습니다:

1. 모델 기반:

ChatGPT는 오픈AI에서 개발한 GPT 시리즈의 언어 모델로, 트랜스포머(Transformer) 논문에서 제안된 아키텍처에 기반을 두고 있습니다. 트랜스포머는 시퀀스 투 시퀀스(Sequence-to-Sequence) 모델을 개선한 구조로, 주로 자연어 처리 작업에서 뛰어난 성능을 보입니다.

반면에 BARD는 구글이 발표한 LaMDA(Language Models for Dialog Applications) 논문에 기반을 두고 있습니다. LaMDA는 대화형 언어 모델에 대한 연구로, ChatGPT와는 다른 모델 아키텍처와 접근 방식을 가지고 있습니다. 따라서 BARD와 ChatGPT는 각각 다른 기반과 특징을 가진 언어 모델입니다.


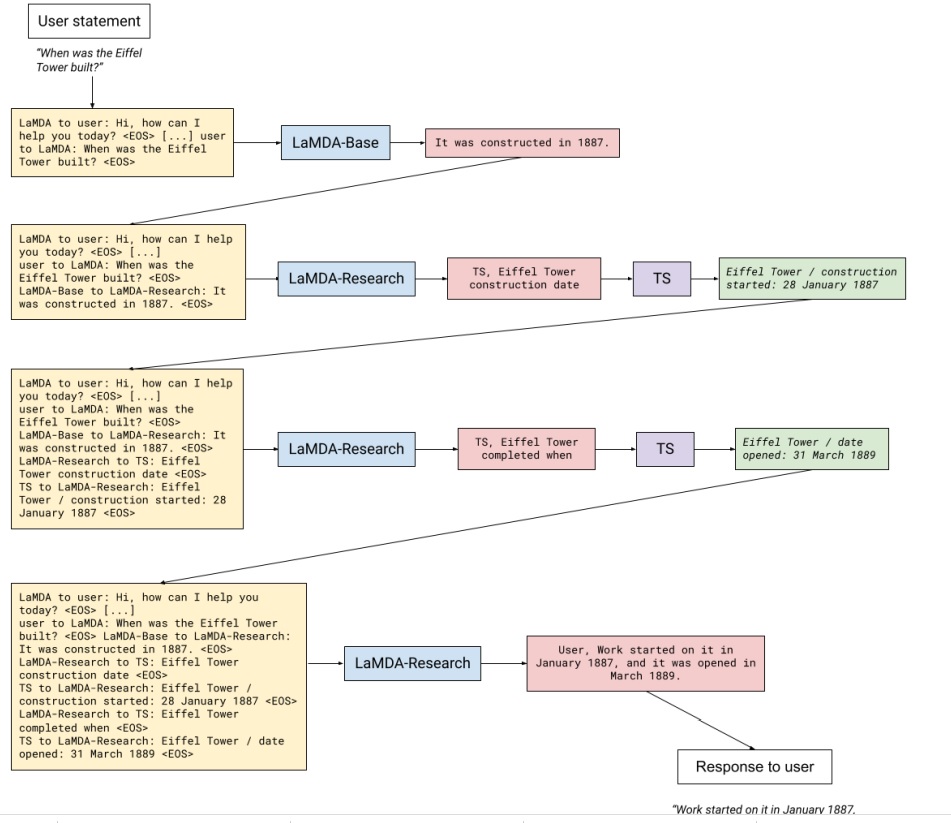
2. 도구를 활용하는 바드: BARD는 효율적인 사실 확인과 숫자 계산을 위해 툴셋(Tool Set, TS)을 사용합니다. LaMDA-Base 모델은 예비 답변을 생성하는 역할을 하고, LaMDA-Research 모델은 인터넷 검색, 번역 및 계산 도구와 협력하여 정확한 답변을 생성합니다.

아래 그림은 람다 논문에 나온 툴셋활용 예시 그림입니다.

“에펠탑은 언제 지어졌니?”라는 유저 질문에 답을 하는 LaMDA 작동 예시입니다.

3. 답변 검증: LaMDA-Research 모델은 이전에 생성된 답변을 검증하고 외부 툴셋이 필요한 경우 해당 도구에 질문과 답변을 제출합니다. 이를 통해 BARD는 더 정확한 답변을 제공할 수 있습니다. ChatGPT는 이와 달리 내부적으로 사실 확인 및 검증을 수행하지 않습니다.

요약하면, BARD는 LaMDA 논문을 기반으로 하며, 툴셋을 활용하여 사실 확인과 숫자 계산의 효율성을 높입니다. 이에 반해 ChatGPT는트랜스포머 모델을 기반으로 하며, 사실 확인과 숫자 계산에 제한이 있을 수 있습니다.

언어모델의 완전 이해 강의 !

트랜스포머 모델로 GPT만들기


언어모델을 이용해 향가를 번역 시켜 보았다. – chatgpt vs deepL 번역 비교

프람프트

아래 글을 해석해줘.
처용가
삼국유사 권제2, 처용랑 망해사, ‘역신을 감복시킨 처용’ 中#
(원문)
東京明期月良
夜入伊遊行如可
入良沙寢矣見昆
脚烏伊四是良羅
二兮隐吾下於叱古
二兮隐誰支下焉古
本矣吾下是如馬於隐
奪叱良乙何如爲理古

chatgpt

해석을 위해 주어진 글을 분석하면서 일부 판단을 내려야 합니다. 주어진 글은 한자와 음역된 문자로 이루어져 있고, 문맥이 불분명하여 정확한 해석이 어렵습니다. 주어진 글은 ‘처용가’라는 제목 아래에 있는 것으로 보이지만, 문장 구조와 의미 파악에 어려움이 있습니다. 따라서, 이 문장을 정확히 해석하는 것은 어려운 일입니다.

해석에 도움이 될 수 있는 정보를 더 제공해주시면, 보다 정확한 도움을 드릴 수 있을 것입니다.

:한자와 음역된 문자로 이루어져 있다는 것은 파악하고 있다.

그래서 번역의 예시를 보여 주었다.

프람프트

東京明期月良 夜入伊遊行如可 入良沙寢矣見昆 脚烏伊四是良羅 二兮隐吾下於叱古 二兮隐誰支下焉古 本矣吾下是如馬於隐 奪叱良乙何如爲理古 (양주동 해) ᄉᆡᄫᆞᆯ ᄇᆞᆯ긔 ᄃᆞ래 밤드리 노니다가 드러ᅀᅡ 자리 보곤 가ᄅᆞ리 네히어라 둘흔 내 해엇고 둘흔 뉘 해언고 本ᄃᆡ 내 해다마ᄅᆞᆫ 아ᅀᅡᄂᆞᆯ 엇디 ᄒᆞ릿고 (현대어 해석) 서라벌 밝은 달에 밤 들어 노니다가 들어와 잠자리 보니 다리가 넷이어라 둘은 내 것인데 둘은 누구의 것인고 본디 내 것이다마는 앗아간 것을 어찌 하리오

chatgpt

주어진 문장을 현대어로 해석하면 다음과 같습니다:

서라벌 밝은 달에
밤 들어 노니다가
들어와 잠자리 보니
다리가 넷이어라
둘은 내 것인데
둘은 누구의 것인가
본디 내 것이다마는
앗아간 것을 어찌 하리오

해석:
서라벌 밝은 달이 떠오르는 때에
밤에 들어가 잠을 자러 갔다가
들어와서 잠자리를 보니
다리가 네 개로 이루어져 있다
둘은 내 것인데
둘은 누구의 것인가
사실은 내 것이지만
빼앗긴 것을 어떻게 해야 하리오

위 문장은 형식적인 한자와 음역된 문자가 혼용된 어법으로 작성되어 있습니다. 전체 문장이 일관된 의미를 갖지 않으며, 문장 구조와 의미 파악에 어려움이 있습니다. 따라서, 위 해석은 일부 추측과 판단을 포함하고 있을 수 있으므로 정확한 의미를 전달하기 위해서는 추가적인 정보가 필요합니다.


deepL 번역

도쿄의 좋은 달
나이트 퍼레이드
료자에서 뵙겠습니다
늑대의 네 발은 량 뤄입니다.
두 사람은 나에게서 숨겨져있다
세상에서 가장 좋은 사람은 누구입니까?
이것은 어둠 속의 말과 같습니다.
량 B의 꾸지람을 빼앗은 이유는 무엇입니까?


결론: 향가와 같은 새로운 형태의 언어번역은 chatgpt가 우월하다.


문장 생성은 토큰을 예측하는 것

문장 생성은 토큰을 예측하는 과정입니다. 트랜스포머 모델은 주어진 입력 시퀀스를 기반으로 다음 토큰을 예측하여 문장을 생성합니다.

문장 생성은 디코더 부분에서 이루어지며, 이전에 생성된 토큰을 입력으로 받아 다음 토큰을 예측합니다. 디코더는 자기 회귀적인 특성을 가지고 있어 이전 단계에서 생성한 토큰을 입력으로 사용하여 다음 토큰을 예측하는 작업을 반복합니다.

문장 생성을 위해 디코더는 어텐션 메커니즘을 사용하여 입력 시퀀스의 다양한 부분을 참조하고, 다음 토큰에 대한 확률 분포를 계산합니다. 일반적으로 확률 분포에서 가장 높은 확률을 가진 토큰을 선택하여 다음 단계의 입력으로 사용합니다. 이런 과정을 반복하여 원하는 길이의 문장을 생성할 수 있습니다.

문장 생성은 자연어 처리 작업에서 중요한 역할을 합니다. 트랜스포머 모델은 문장 생성을 통해 기계 번역, 요약, 대화 시스템 등 다양한 응용 분야에서 활용됩니다.